ডুপ্লিকেট এফিলিয়েট কনটেন্ট ক্লিনআপ
এফিলিয়েট মার্কেটিংয়ে ডুপ্লিকেট কনটেন্ট কী এবং কেন সমস্যা
ডুপ্লিকেট এফিলিয়েট কনটেন্ট ক্লিনআপ বলতে এমন সব পেজ, প্রোডাক্ট বর্ণনা, ক্যাটাগরি কপি, ট্যাগ আর্কাইভ, ফিল্টার করা ইউআরএল, বা সিন্ডিকেটেড লেখা শনাক্ত করে ঠিক করা বোঝায় যেগুলো একই বা খুব কাছাকাছি তথ্য বারবার দেখায়। এফিলিয়েট সাইটে এই সমস্যা বেশি হয়, কারণ অনেকেই মার্চেন্টের দেওয়া রেডিমেড প্রোডাক্ট ডিসক্রিপশন, রিভিউ টেমপ্লেট, স্পেসিফিকেশন টেবিল, এমনকি মেটা টাইটেলও হুবহু ব্যবহার করেন। এতে সার্চ ইঞ্জিন বুঝতে কষ্ট পায় কোন পেজটি আসল, কোনটি বেশি দরকারি, আর কোনটি ইনডেক্সে রাখা উচিত।
এখানে একটি গুরুত্বপূর্ণ বিষয় হলো, সব ডুপ্লিকেট কনটেন্টের জন্য সরাসরি “শাস্তি” নেমে আসে না। কিন্তু একই রকম কনটেন্ট থাকলে crawl budget নষ্ট হয়, internal competition তৈরি হয়, canonical confusion হয়, আর ranking signals একাধিক ইউআরএলে ছড়িয়ে যায়। ফলে এফিলিয়েট মার্কেটিং কনটেন্ট optimization দুর্বল হয়ে যায়, অর্গানিক ট্রাফিক কমে, আর কনভার্সনেও প্রভাব পড়ে।
ডুপ্লিকেট কনটেন্ট এফিলিয়েট মার্কেটিং-এ কীভাবে প্রভাব ফেলে
যদি আপনার সাইটে একই কীওয়ার্ড টার্গেট করে একাধিক রিভিউ, “best of” তালিকা, বা প্রায় একই ল্যান্ডিং পেজ থাকে, তাহলে Google বা অন্য সার্চ ইঞ্জিন একটি নির্দিষ্ট পেজকে শক্তভাবে র্যাঙ্ক করাতে দ্বিধায় পড়ে। এটাকে অনেক সময় keyword cannibalization-এর সাথেও দেখা যায়। বিশেষ করে affiliate site SEO-তে এটা খুব সাধারণ, কারণ একই পণ্যের জন্য অনেকগুলো ভ্যারিয়েশন পেজ তৈরি করা হয়।
এর বাস্তব প্রভাব হলো: একটি ভালো পেজের বদলে মাঝারি মানের অন্য পেজ ইনডেক্স হতে পারে, পুরোনো URL rank করতে পারে, অথবা search results-এ একবার এক পেজ আবার আরেকবার আরেক পেজ দেখাতে পারে। এর ফলে trust signal, backlink equity, topical relevance, এবং user engagement data এক জায়গায় জমা হয় না। তাই ডুপ্লিকেট কনটেন্ট এফিলিয়েট মার্কেটিং সমস্যাকে ছোট করে দেখলে ক্ষতি বেশি হয়।
Search engines ডুপ্লিকেট কনটেন্ট penalty আসলে কী
“Google ডুপ্লিকেট কনটেন্ট penalty” কথাটা অনেকেই খুব ভয় পান, কিন্তু বাস্তবে বেশিরভাগ ক্ষেত্রে সার্চ ইঞ্জিন সরাসরি manual action না দিয়ে ডুপ্লিকেট পেজগুলো ফিল্টার করে, কম গুরুত্ব দেয়, বা canonical version নিজে বেছে নেয়। তবে যদি scraping, doorway pages, spun কনটেন্ট, বা mass-generated thin affiliate pages থাকে, তখন সমস্যা গুরুতর হতে পারে।
অর্থাৎ, penalty সবসময় “অ্যাকাউন্ট শাস্তি” আকারে না এলেও SEO impact of ডুপ্লিকেট কনটেন্ট বাস্তব এবং দীর্ঘমেয়াদি। ইন্ডেক্সেশন সমস্যা, low-value কনটেন্ট classification, SERP visibility হ্রাস, এবং revenue drop—সবই এর অংশ। তাই শুরুতেই identify ডুপ্লিকেট কনটেন্ট on website করে cleanup plan নেওয়াই ভালো।
ডুপ্লিকেট কনটেন্ট হওয়ার সাধারণ কারণগুলো কী
Affiliate সাইটে ডুপ্লিকেট কনটেন্ট অনেক সময় ইচ্ছাকৃতভাবে নয়, টেকনিক্যাল সেটআপের কারণেও তৈরি হয়। যেমন URL parameters, tracking codes, sort/filter pages, pagination, HTTP/HTTPS mismatch, trailing slash variation, www এবং non-www version—এসব কারণে একই কনটেন্ট একাধিক URL-এ দেখা যেতে পারে। WordPress, WooCommerce, tag archive, category archive এবং attachment page থেকেও সমস্যা হয়।
যদি আপনার হোস্টিং পরিবেশ ঠিকভাবে কনফিগার না করা থাকে, তাহলে crawl control ও redirect rule ম্যানেজ করাও কঠিন হয়। বড় সাইটের ক্ষেত্রে স্থিতিশীল server environment দরকার হয়, যাতে canonical headers, redirect mapping, log analysis, cache behavior, এবং sitemap control ঠিকমতো কাজ করে। এ ধরনের অবকাঠামোগত পরিকল্পনায় Cloudoora-এর মতো cloud platform বা managed server environment বিবেচনায় আনা যেতে পারে, বিশেষ করে যখন সাইট দ্রুত বাড়ছে।
URL parameter, session ID, এবং filtered page
অনেক affiliate সাইটে একই প্রোডাক্ট পেজে ?ref=, ?sort=price, ?utm=, বা session ID যুক্ত হয়ে একাধিক URL তৈরি হয়। ব্যবহারকারীর চোখে কনটেন্ট একই, কিন্তু crawler-এর কাছে এগুলো আলাদা পেজ। এতে index bloat হয় এবং signals ভাগ হয়ে যায়।
বিশেষ করে eCommerce affiliate কনটেন্ট-এ faceted navigation একটি বড় সমস্যা। যেমন “ল্যাপটপ” পেজের আবার “ব্র্যান্ড”, “দাম”, “র্যাম”, “স্টক” অনুযায়ী অনেক filtered version তৈরি হতে পারে। সঠিক canonical tag, robots directives, এবং parameter handling না থাকলে এগুলো সহজেই ডুপ্লিকেট কনটেন্ট issues তৈরি করে।
কনটেন্ট scraping, syndication, এবং copied merchant copy
অনেক affiliate প্রকাশক merchant feed থেকে প্রোডাক্ট টাইটেল, bullet points, description, এবং specification হুবহু কপি করেন। আবার কেউ কেউ অন্য ব্লগের review rewrite না করে সামান্য পরিবর্তন করে প্রকাশ করেন। এতে কনটেন্ট uniqueness কমে যায়, আর একই বিষয়ে শত শত সাইটের মধ্যে আপনার পেজের আলাদা মূল্য থাকে না।
সিন্ডিকেটেড কনটেন্টও সমস্যা তৈরি করতে পারে, যদি original source পরিষ্কার না হয় বা rel=canonical ব্যবহার না করা হয়। scraping বটের কারণে আপনার নিজের লেখাও অন্য সাইটে নকল হয়ে যেতে পারে। তাই শুধু নিজের সাইট নয়, ওয়েব জুড়ে duplicate footprint খুঁজে দেখা দরকার।
Canonical URL ভুল বোঝা
অনেকেই ভাবেন canonical tag বসালেই সব সমস্যা শেষ। বাস্তবে canonical হলো একটি strong hint, absolute rule নয়। যদি canonical target 404 দেয়, noindex হয়, redirect loop-এ যায়, বা কনটেন্ট mismatch থাকে, তাহলে সার্চ ইঞ্জিন সেটি মানতে নাও পারে।
আরেকটি সাধারণ ভুল হলো self-referencing canonical না রাখা, অথবা paginated series, print version, mobile variation, এবং parameter page-এ ভুল canonical বসানো। technical SEO-তে এসব ছোট ভুলও বড় crawl ও index সমস্যা তৈরি করতে পারে।
কীভাবে নিজের ওয়েবসাইটে ডুপ্লিকেট কনটেন্ট শনাক্ত করবেন
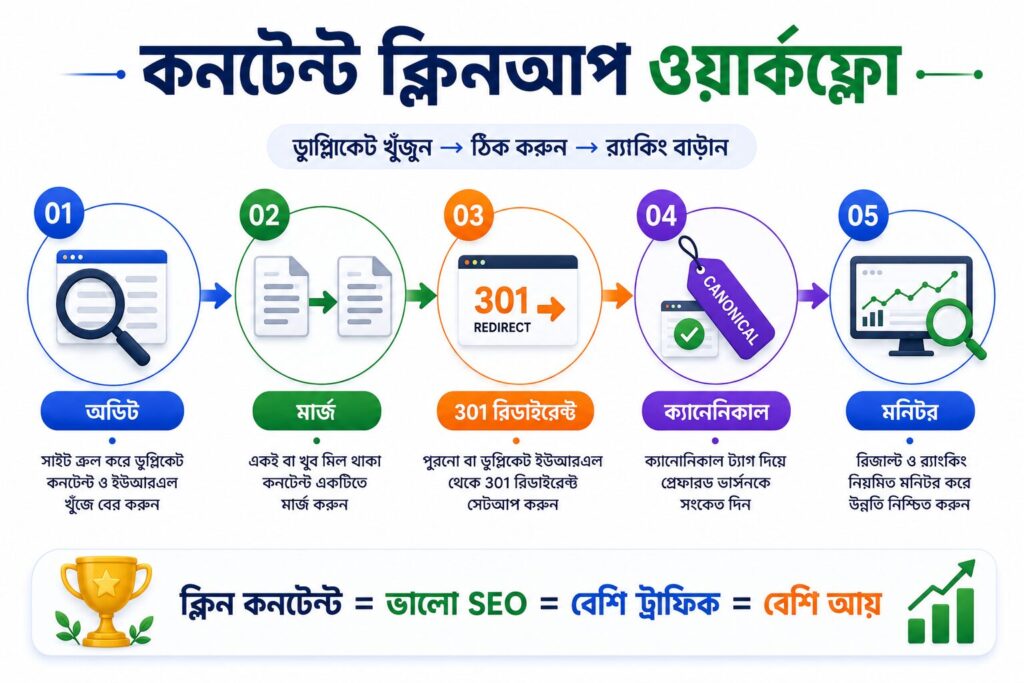
ডুপ্লিকেট এফিলিয়েট কনটেন্ট ক্লিনআপের প্রথম ধাপ হলো কনটেন্ট audit। শুধু চোখে দেখে বোঝা যায় না; URL structure, meta title, H1, body copy similarity, canonical tag, index status, এবং internal linking pattern—সবকিছু মিলিয়ে দেখতে হয়। Google Search Console, site crawl, XML sitemap, server log, analytics landing page data, এবং search query overlap বিশ্লেষণ করলে duplicate cluster ধরা পড়ে।
আপনি যদি নিয়মিত কনটেন্ট audit for affiliate sites না করেন, তাহলে পুরোনো review, expired offer page, thin comparison page, auto-generated tag archive, এবং duplicate category intro অনেকদিন ধরা ছাড়া পড়ে থাকতে পারে। তাই audit-কে একবারের কাজ না ভেবে চলমান প্রক্রিয়া হিসেবে ধরুন।
কোন ডুপ্লিকেট কনটেন্ট detection tools ব্যবহার করা যায়
ডুপ্লিকেট কনটেন্ট খুঁজতে কয়েক ধরনের টুল কাজে লাগে। কিছু টুল সাইট crawl করে internal duplicate বের করে, কিছু টুল web-wide matching দেখায়, আর কিছু টুল title, meta description, canonical, status code, এবং near-duplicate text detect করে।
- Google Search Console: ইনডেক্সড পেজ, canonical selection, coverage issue, duplicate without user-selected canonical শনাক্ত করতে সাহায্য করে
- Screaming Frog-এর মতো crawler: title, H1, word count, canonical, redirect chain, parameter URL বিশ্লেষণে কার্যকর
- ডুপ্লিকেট কনটেন্ট checker: দ্রুত টেক্সট similarity যাচাই করতে সহায়ক
- Copyscape বা অনুরূপ টুল: ওয়েবজুড়ে কপি হওয়া কনটেন্ট শনাক্ত করতে কাজে আসে
- Site search operator: Google-এ “site:domain.com” দিয়ে index pattern দেখা যায়
Step-by-step কনটেন্ট audit কীভাবে করবেন
প্রথমে সব indexable URL-এর একটি তালিকা নিন। এরপর title tag, meta description, H1, canonical, status code, word count, এবং primary keyword মিলিয়ে duplicate group তৈরি করুন। একদম একই কপি আর কাছাকাছি কপি—দুই ধরনের তালিকা আলাদা রাখুন।
- XML sitemap ও crawler report মিলিয়ে URL inventory তৈরি করুন
- parameter, tag, archive, filter, search result page আলাদা করুন
- যেসব পেজ একই intent টার্গেট করছে সেগুলো cluster করুন
- traffic, backlinks, conversions, impressions দেখে best version বেছে নিন
- merge, redirect, canonicalize, noindex, বা rewrite—কোন সমাধান লাগবে তা ঠিক করুন
এ সময় analytics data খুব কাজে দেয়। ধরুন তিনটি “best hosting for beginners” ধরনের affiliate পেজ আছে, কিন্তু একটিতেই সবচেয়ে বেশি organic clicks ও affiliate conversions হচ্ছে। তাহলে ওই পেজকে primary ধরে বাকি দুটিকে merge বা redirect করা যুক্তিযুক্ত।
Cleaning ডুপ্লিকেট কনটেন্ট best practices কী কী
Effective ডুপ্লিকেট কনটেন্ট removal মানে সব duplicate পেজ মুছে ফেলা নয়। কখনও merge করতে হয়, কখনও rewrite, কখনও canonical, কখনও noindex, আর কখনও 301 redirect সবচেয়ে ভালো সমাধান। লক্ষ্য হলো search engine-কে পরিষ্কার signal দেওয়া—কোন URL canonical, কোনটি secondary, কোনটি index হওয়া উচিত নয়, আর কোনটি deprecated।
এখানে কনটেন্ট, technical SEO, এবং site architecture—তিনটি স্তরে কাজ করতে হয়। বিশেষ করে বড় affiliate সাইটে redirect map, internal links update, sitemap cleanup, cache purge, এবং recrawl monitoring ছাড়া কাজ অসম্পূর্ণ থেকে যায়।
301 redirect, canonical tag, noindex—কখন কোনটি ব্যবহার করবেন
যদি দুটি পেজ প্রায় একই হয় এবং একটি রাখলেই চলে, তাহলে 301 redirect সাধারণত সবচেয়ে পরিষ্কার সমাধান। এতে link equity, user signals, এবং relevance এক জায়গায় জমা হয়। পুরোনো review URL থেকে updated evergreen review URL-এ redirect দেওয়া affiliate সাইটে খুবই সাধারণ কাজ।
আর যদি একাধিক version ব্যবহারকারীর জন্য দরকারি হয়, কিন্তু rank করতে একটিকেই চান, তাহলে canonical tag ব্যবহার করুন। search result page, print version, tracked URL, বা filtered variation-এর ক্ষেত্রে noindex-ও কাজে লাগে। তবে noindex পেজে internal linking strategy আলাদা করে ভাবতে হবে।
Effective ডুপ্লিকেট কনটেন্ট removal strategy
- একই intent-এর পেজ merge করে একটি শক্তিশালী pillar page বানান
- Merchant-provided copy rewrite করে নিজের analysis, pros-cons, pricing context, এবং বাংলাদেশি ব্যবহারকারীর দৃষ্টিভঙ্গি যোগ করুন
- Boilerplate কনটেন্ট কমান, বিশেষ করে category intro ও comparison template-এ
- Tag/archive page indexable রাখার আগে unique কনটেন্ট আছে কি না দেখুন
- Internal link-এ সবসময় preferred canonical URL ব্যবহার করুন
- Sitemap থেকে duplicate, redirected, noindex URL সরিয়ে দিন
এফিলিয়েট মার্কেটিং কনটেন্ট optimization-এর দৃষ্টিতে সবচেয়ে ভালো ফল আসে যখন আপনি শুধু “কপি সরান” না, বরং কনটেন্ট value বাড়ান। যেমন একটি hosting review-তে uptime, support quality, pricing caveat, local payment support, beginner suitability, আর performance test যোগ করলে সেটি আর generic থাকে না।
ভবিষ্যতে ডুপ্লিকেট কনটেন্ট issues কীভাবে প্রতিরোধ করবেন
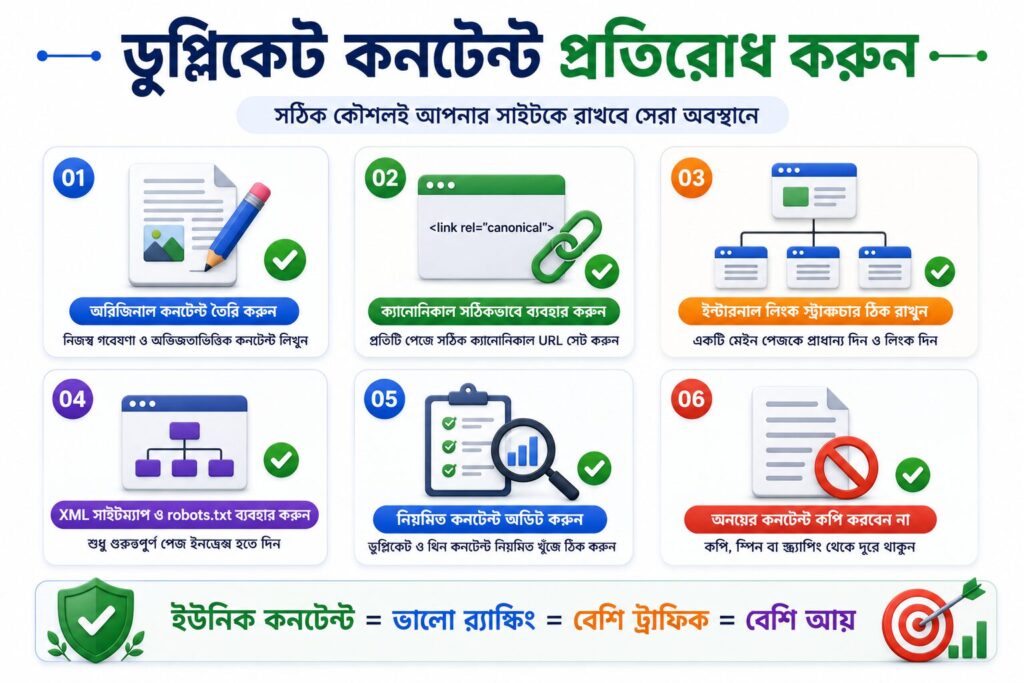
প্রকাশের আগেই editorial workflow-এ uniqueness check রাখুন। প্রতিটি নতুন পেজের জন্য primary keyword, search intent, target audience, এবং internal linking target আগে নির্ধারণ করুন। এতে একই বিষয়ের উপর অকারণে একাধিক article তৈরি হওয়ার সম্ভাবনা কমে।
এছাড়া CMS configuration-এ permalink rule, category/tag policy, canonical setup, pagination handling, schema consistency, এবং template variation নিয়ন্ত্রণ করুন। বড় affiliate সাইট হলে staging environment ব্যবহার করা ভালো, যাতে live index-এ সমস্যা যাওয়ার আগেই পরীক্ষা করা যায়।
এফিলিয়েট মার্কেটিং কনটেন্ট optimization কীভাবে করবেন
ডুপ্লিকেট কনটেন্ট পরিষ্কার করার পরের ধাপ হলো কনটেন্ট strategy শক্ত করা। শুধু unique wording যথেষ্ট নয়; আপনার কনটেন্টে expertise, comparison depth, first-hand insight, buyer intent matching, এবং clear recommendation থাকতে হবে। অর্থাৎ এফিলিয়েট মার্কেটিং কনটেন্ট strategy এমন হতে হবে যাতে প্রতিটি পেজের একটি নির্দিষ্ট কাজ থাকে।
একটি পেজ informational, আরেকটি comparison, আরেকটি transactional—এভাবে intent mapping করলে redundancy কমে যায়। একই সঙ্গে topical cluster গড়া সহজ হয়। যেমন “সেরা VPN”, “VPN কীভাবে কাজ করে”, “স্ট্রিমিংয়ের জন্য VPN”, “বাংলাদেশে VPN ব্যবহারের গাইড”—এসব আলাদা intent মেনে লিখলে duplicate হওয়ার ঝুঁকি কম থাকে।
কীওয়ার্ড ব্যবহার করবেন, কিন্তু কপি যেন একরকম না হয়
Secondary keyword ব্যবহার করতে হবে, তবে keyword stuffing করা যাবে না। “ডুপ্লিকেট কনটেন্ট এফিলিয়েট মার্কেটিং”, “cleaning ডুপ্লিকেট কনটেন্ট best practices”, “identify ডুপ্লিকেট কনটেন্ট on website”, “tools for ডুপ্লিকেট কনটেন্ট cleanup” বা “improve affiliate site SEO” ধরনের শব্দগুলো স্বাভাবিকভাবে বসান। প্রতিটি সেকশনে semantic relevance রাখুন, কিন্তু এক বাক্য আরেকবার লিখবেন না।
একই টপিকের তিনটি পেজ লিখলে তিনটির কাঠামোও আলাদা রাখুন। একটিতে problem-solution angle, একটিতে comparison angle, আরেকটিতে beginner guide angle নিতে পারেন। এতে topical authority বাড়ে, আর একই তথ্য ঘুরিয়ে ফিরিয়ে লেখার দরকার হয় না।
Original affiliate কনটেন্ট-এর বাস্তব কাঠামো
- নিজস্ব ভূমিকা ও problem framing
- Feature list নয়, ব্যবহারভিত্তিক বিশ্লেষণ
- কার জন্য ভালো, কার জন্য নয়
- Pricing context ও hidden limitation
- Local relevance, যেমন বাংলাদেশে payment বা speed experience
- Frequently updated comparison data
যদি hosting, server, proxy, বা cloud service review করেন, তাহলে বাস্তব testing environment, latency, support response, dashboard usability, এবং deployment ease উল্লেখ করলে কনটেন্ট আলাদা মান পায়। উদাহরণ হিসেবে server environment নিয়ে আলোচনা করতে গেলে Cloudoora-এর মতো প্ল্যাটফর্মের ক্ষেত্রে কপি-পেস্ট বর্ণনার বদলে ব্যবহারভিত্তিক বিশ্লেষণ অনেক বেশি কার্যকর।
ডুপ্লিকেট কনটেন্ট ক্লিনআপের বাস্তব উদাহরণ
ধরুন একটি affiliate সাইটে “best budget hosting”, “cheap hosting for beginners”, এবং “low cost web hosting” নামে তিনটি আলাদা পেজ আছে। তিনটিতেই প্রায় একই provider list, একই pros-cons, একই CTA, আর একই FAQ। audit-এ দেখা গেল তিনটি পেজই একই search intent টার্গেট করছে। সমাধান হিসেবে সবচেয়ে শক্তিশালী URL বেছে বাকি দুইটি merge করে 301 redirect দিলে organic visibility ধীরে ধীরে স্থিতিশীল হয়।
আরেক ক্ষেত্রে দেখা যায়, ৫০০টি product page merchant feed থেকে auto-import করা হয়েছে। title, description, specification—সবই একই ধরনের। সেখানে শুধুই ডুপ্লিকেট কনটেন্ট checker চালালেই হবে না; template redesign, কনটেন্ট pruning, noindex policy, এবং priority category page strategy নিতে হয়। এতে thin pages কমে এবং crawl efficiency বাড়ে।
কী শেখার আছে এসব উদাহরণ থেকে
- সব duplicate page সমান নয়; business value দেখে সিদ্ধান্ত নিতে হয়
- High-traffic page আগে ঠিক করলে দ্রুত ফল দেখা যায়
- Rewrite ছাড়া শুধু canonical দিয়ে সব সমস্যা মেটে না
- Template-level duplication affiliate সাইটে খুব সাধারণ
- Cleanup-এর পরে rank tracking, indexing, এবং click-through rate মনিটর করা জরুরি
অনেক সময় penalty বলে যা মনে হয়, সেটা আসলে index selection সমস্যা, thin কনটেন্ট, বা weak differentiation। তাই panic না করে data-driven cleanup সবচেয়ে ভালো পথ।
অতিরিক্ত রিসোর্স ও যোগাযোগ তথ্য
ডুপ্লিকেট এফিলিয়েট কনটেন্ট ক্লিনআপ ঠিকভাবে করতে চাইলে কয়েকটি রিসোর্স হাতের কাছে রাখা ভালো। যেমন কনটেন্ট inventory sheet, URL mapping document, redirect checklist, canonical audit template, এবং recurring কনটেন্ট audit schedule। এগুলো থাকলে cleanup কাজ গুছিয়ে করা যায় এবং পরে একই সমস্যা ফের তৈরি হচ্ছে কি না তা ধরাও সহজ হয়।
আপনি যদি hosting review, VPS কনটেন্ট, server comparison, বা infrastructure-focused affiliate site চালান, তাহলে content-এর পাশাপাশি technical setup-ও গুরুত্বপূর্ণ। দ্রুত crawl, স্থিতিশীল response, সঠিক redirect behavior, এবং clean deployment environment রাখার জন্য পরিকল্পিত হোস্টিং প্রয়োজন হতে পারে। এই প্রসঙ্গে Cloudoora-এর মতো প্ল্যাটফর্ম নিয়ে গবেষণা করা যেতে পারে, বিশেষ করে performance-sensitive সাইটের ক্ষেত্রে।
Duphat contact number বিষয়ে একটি নোট
“duphat contact number” একটি related search হিসেবে দেখা যেতে পারে, কিন্তু এটি আপনার ডুপ্লিকেট কনটেন্ট cleanup strategy-র মূল অংশ নয়। কোনো বাহ্যিক সেবা ব্যবহার করার আগে তাদের যোগাযোগ তথ্য, সাপোর্ট মান, data privacy policy, এবং SEO methodology যাচাই করা জরুরি। বিশেষ করে আপনি যদি third-party audit service নেন, তাহলে তারা কনটেন্ট access, CMS permissions, এবং redirect changes কীভাবে সামলাবে তা আগে পরিষ্কার করুন।
আরও যেসব রিসোর্স কাজে লাগবে
- ডুপ্লিকেট এফিলিয়েট কনটেন্ট ক্লিনআপ সম্পর্কিত গাইড
- ডুপ্লিকেট কনটেন্ট এফিলিয়েট মার্কেটিং বিষয়ে সহায়ক রিসোর্স
- এফিলিয়েট মার্কেটিং কনটেন্ট strategy পরিকল্পনা
- কনটেন্ট audit for affiliate sites চেকলিস্ট
- improve affiliate site SEO সম্পর্কিত টেকনিক্যাল টিপস
উপসংহার
ডুপ্লিকেট এফিলিয়েট কনটেন্ট ক্লিনআপ শুধু SEO-এর একটি ছোট টেকনিক্যাল কাজ নয়; এটি পুরো affiliate সাইটের গুণমান, র্যাঙ্কিং স্থিতি, crawl efficiency, এবং কনভার্সনের সঙ্গে জড়িত। একই ধরনের পেজ, copied merchant copy, parameter URL, canonical ভুল, আর thin archive page—এসব ঠিক না করলে ভালো কনটেন্টও ঠিকমতো ফল দেয় না।
সবচেয়ে কার্যকর পদ্ধতি হলো আগে identify ডুপ্লিকেট কনটেন্ট on website, তারপর data দেখে সিদ্ধান্ত নেওয়া—কোথাও rewrite, কোথাও merge, কোথাও 301 redirect, কোথাও canonical, আর কোথাও noindex। এর সঙ্গে editorial planning, technical SEO, এবং নিয়মিত কনটেন্ট audit যুক্ত করতে পারলে ডুপ্লিকেট কনটেন্ট issues অনেকটাই নিয়ন্ত্রণে রাখা সম্ভব। দীর্ঘমেয়াদে এটাই improve affiliate site SEO করার সবচেয়ে বাস্তবসম্মত পথ।
প্রায় জিজ্ঞাসিত প্রশ্ন (FAQ)
ডুপ্লিকেট কনটেন্ট কি সরাসরি Google penalty দেয়?
সবসময় না। অনেক ক্ষেত্রে Google শুধু একটি version বেছে নেয় এবং বাকিগুলো কম দেখায় বা ইনডেক্সই করে না। তবে scraping, thin affiliate page, বা mass duplication থাকলে বড় ক্ষতি হতে পারে।
Affiliate সাইটে সবচেয়ে বেশি কোন ধরনের ডুপ্লিকেট কনটেন্ট দেখা যায়?
Merchant-provided product description, similar review template, category/archive intro, URL parameter variation, tag page, এবং filtered listing page সবচেয়ে বেশি দেখা যায়।
আমি কীভাবে identify ডুপ্লিকেট কনটেন্ট on website করব?
Google Search Console, crawler tool, ডুপ্লিকেট কনটেন্ট checker, XML sitemap review, এবং manual SERP analysis ব্যবহার করুন। title, H1, meta, body similarity, canonical, এবং index status একসাথে দেখলে ভালো ফল পাওয়া যায়।
সব duplicate page কি delete করে দেওয়া উচিত?
না। কিছু পেজ merge করা ভালো, কিছু redirect করতে হয়, কিছু canonical, আর কিছু rewrite করতে হয়। business value, traffic, backlinks, এবং search intent দেখে সিদ্ধান্ত নিন।
Canonical tag আর 301 redirect-এর মধ্যে পার্থক্য কী?
301 redirect ব্যবহারকারী ও crawler-কে নতুন URL-এ পাঠিয়ে দেয়। canonical tag শুধু জানায় কোন URL preferred version, কিন্তু অন্য URL তখনও অ্যাক্সেসযোগ্য থাকে।
কোন tools for ডুপ্লিকেট কনটেন্ট cleanup সবচেয়ে কাজে লাগে?
Search Console, Screaming Frog ধরনের crawler, Copyscape, আর একটি নির্ভরযোগ্য ডুপ্লিকেট কনটেন্ট checker—এই কম্বিনেশন বেশ কার্যকর।
এফিলিয়েট মার্কেটিং কনটেন্ট optimization করতে গিয়ে কী ভুল বেশি হয়?
একই search intent-এর জন্য একাধিক পেজ বানানো, keyword variation ধরে আলাদা আলাদা পাতলা article লেখা, আর merchant copy rewrite না করা—এই ভুলগুলো সবচেয়ে বেশি হয়।
ডুপ্লিকেট কনটেন্ট ক্লিনআপের পরে ফল পেতে কত সময় লাগে?
সাইটের আকার, crawl frequency, redirect implementation, এবং কনটেন্ট quality অনুযায়ী সময় বদলায়। ছোট সাইটে কয়েক সপ্তাহের মধ্যে পরিবর্তন দেখা যেতে পারে, বড় সাইটে বেশি সময় লাগতে পারে।